


具身智能数采转向众包模式,客户数据需求暴涨到千万小时


媒体报道,具身智能数据采集产业正在发生模式变革,众包采集模式涌现与集中式采集厂规模化落地两条路径同时在扩产,而数据采集的作业规范与质量评测标准仍待建立。
多位从业者表示,具身智能企业、世界模型公司、大模型厂商与科研院校是主要需求方,不少客户的数据需求已从百万小时级迈向千万小时级,觅蜂科技董事长兼CEO姚卯青此前称,行业已实现的百万小时级数据无法满足需求。而中国信息通信研究院报告显示,机器人实现「ChatGPT」时刻所需训练数据量约1.1万亿词元。
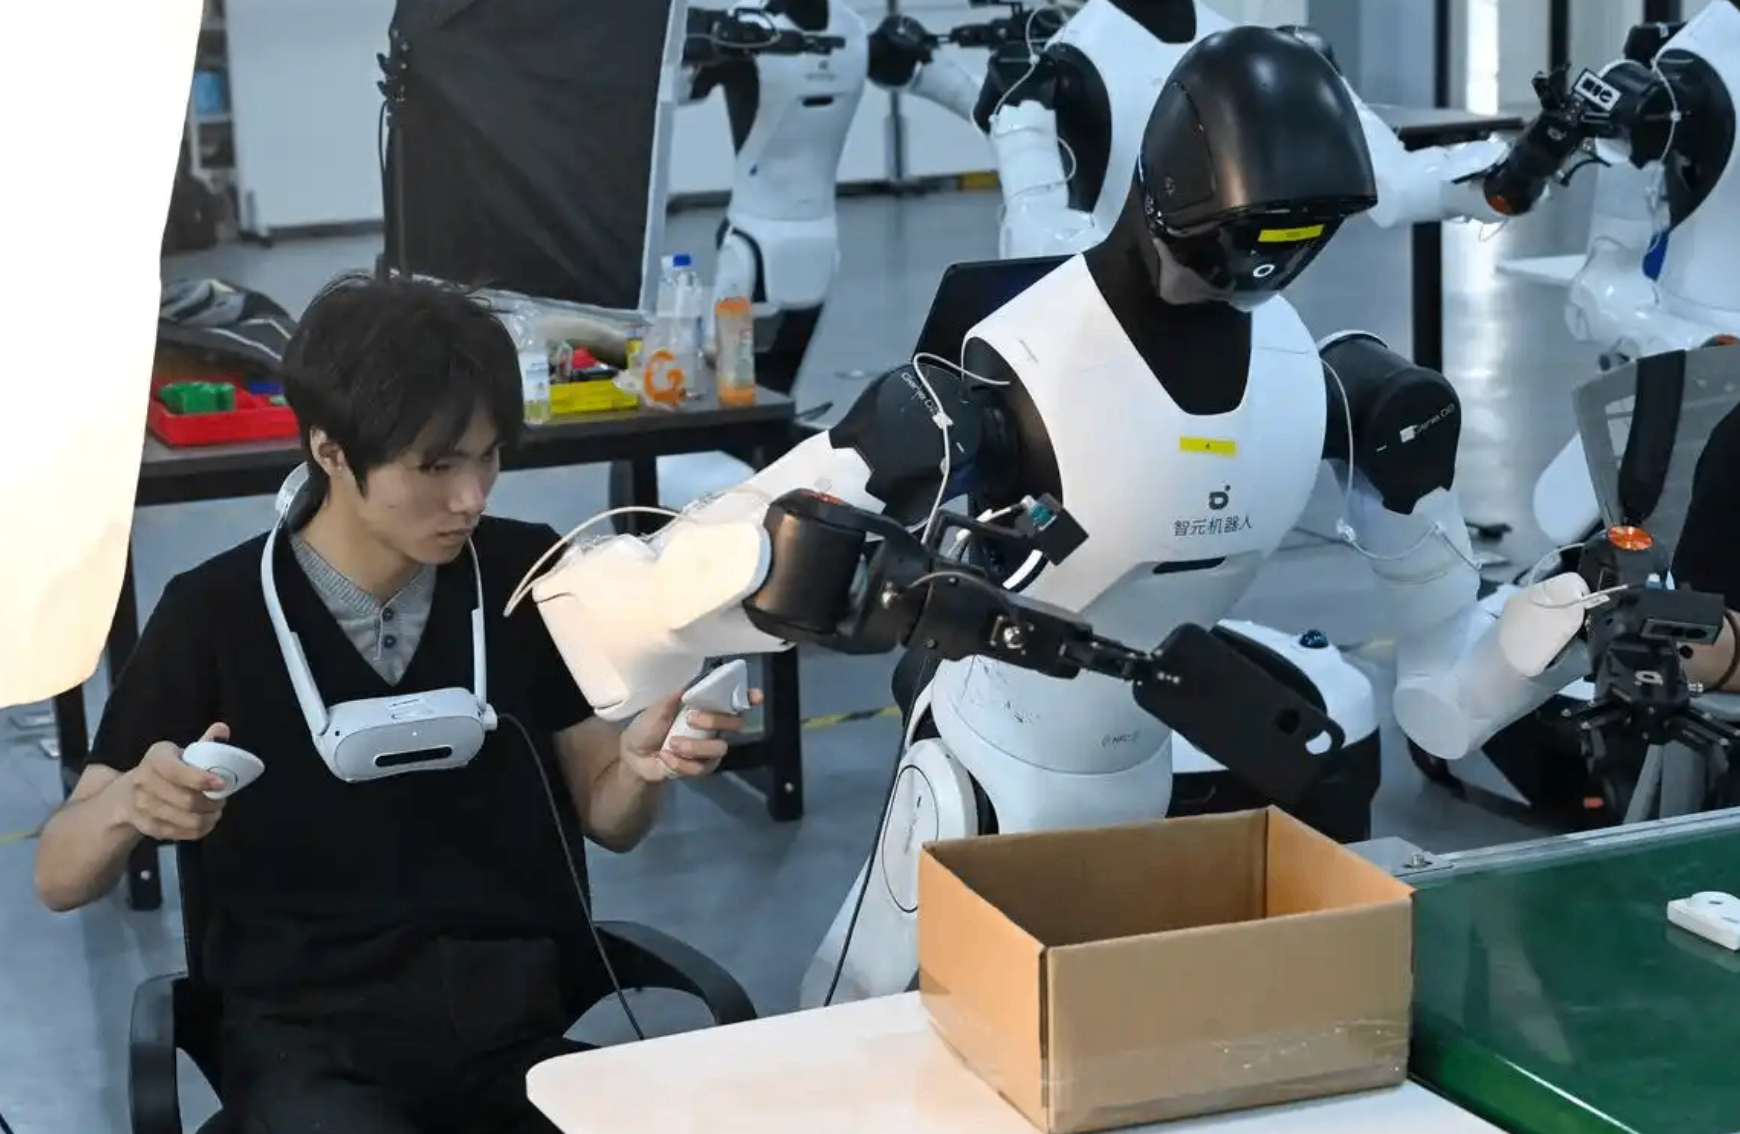
据介绍,智元创新控股子公司觅蜂科技今年9月23日开启数据采集众包模式,允许普通人申领设备、完成任务并获得收入,已在40个城市落地。其北京某合作方介绍,申领人每小时采集可得10元至30元收入。
京东计划发动内部超过10万名不同职业的员工,以及外部最多50万名各行业人员参与采集,宿迁机器人数据采集中心计划发动超过10万名市民,目标是一年内积累500万小时人类真实场景视频数据、两年内突破1000万小时。这种采集多采用头戴式设备或加配末端执行器,无需采购十几万元级的机器人本体。
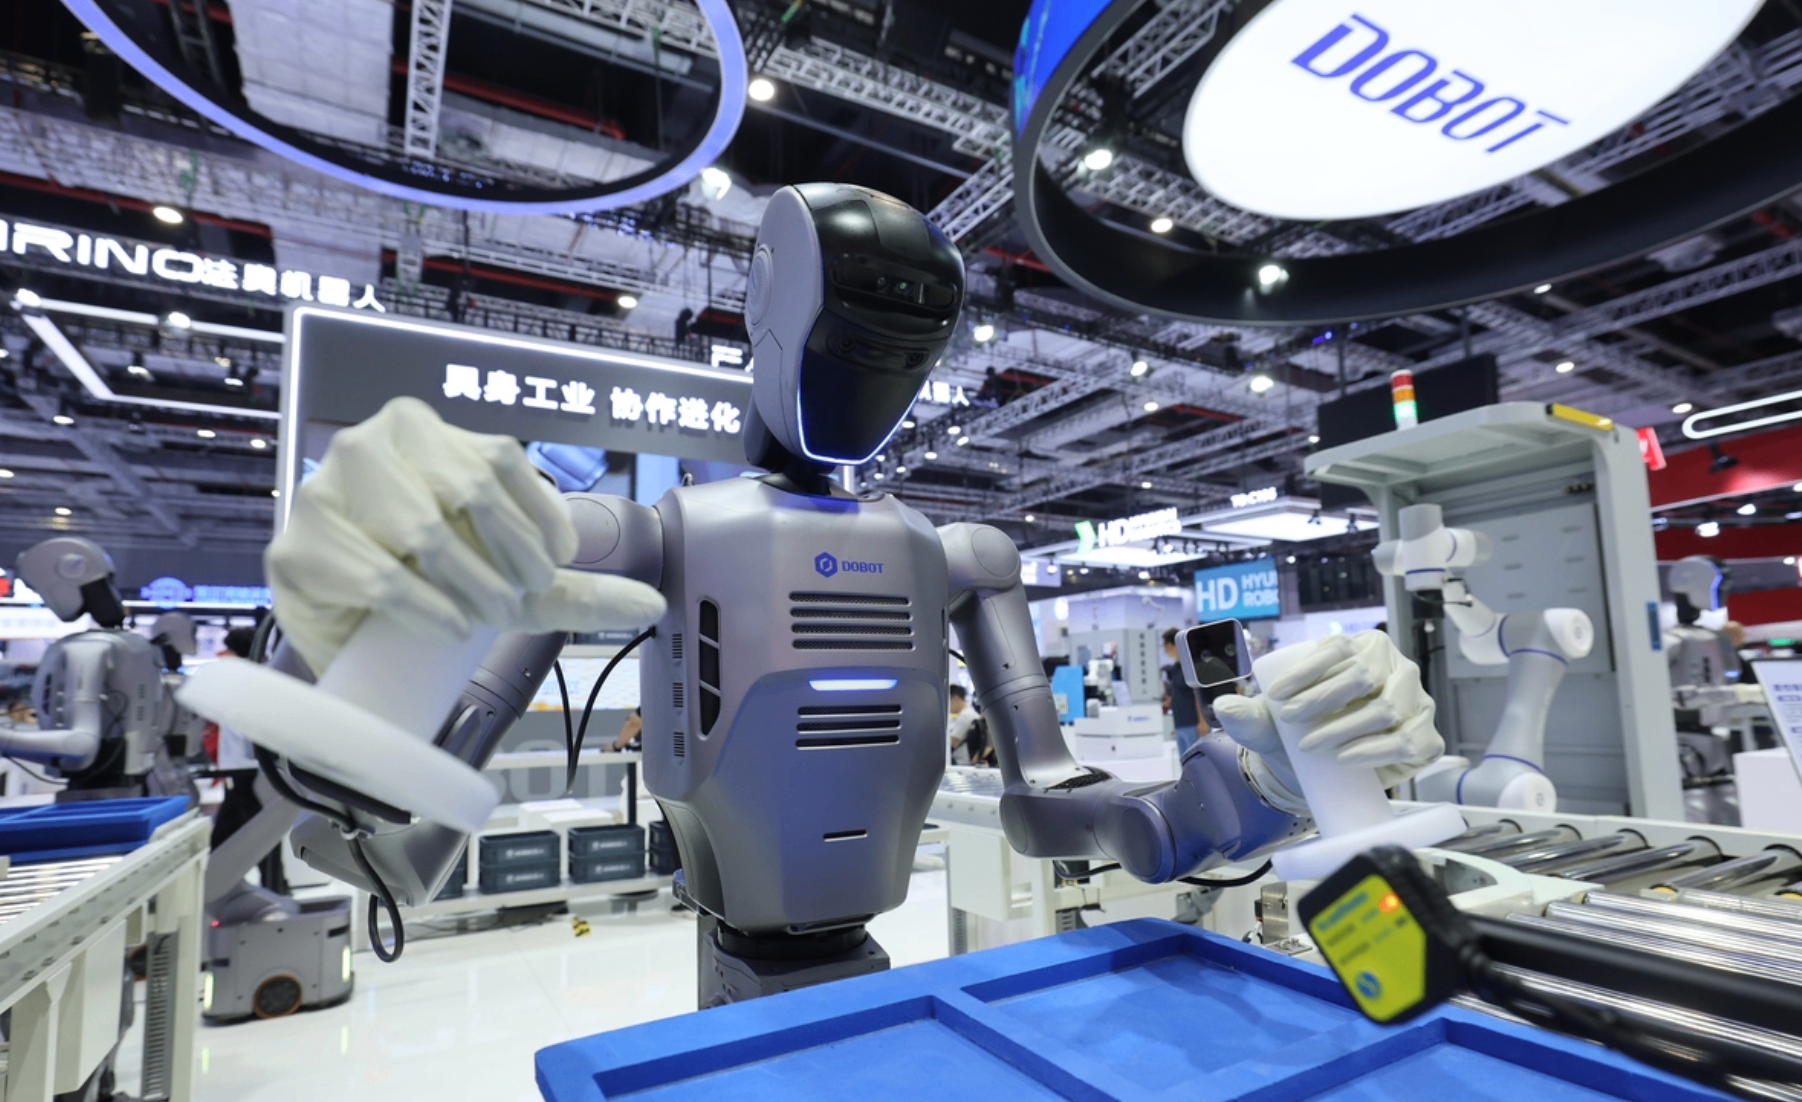
全国已建成启用70多家具身智能训练场,在建、规划40余家。位于北京亦庄的北京人形机器人创新中心数据与训练基地内,150台不同构型机器人设备与100余台无本体采集设备在30余个场景作业,年产能可达18万小时,已交付近3万小时高质量数据,七成以上产能服务行业客户。
但数据采集标准缺失目前还是一道卡点,某采集公司负责人介绍,众包采集链条长、环节多,无效数据与重复度高的问题突出,普通场景数据已接近饱和,工厂、高危作业等垂类场景数据依旧稀缺。
帕西尼相关负责人提到,单纯按采集成本定价并不合理,数据价值要看场景真实性、多样性、模态丰富度与可复用性。姚卯青提出数据质量标准、采集验收规范、定价与流通标准三项需求,并强调从知情同意、端侧脱敏到分级存储的全链路合规规范是行业获得公众认可的生命线。
采集量级从百万小时跳到千万小时,这条赛道的成本结构、组织方式与合规要求都要同步重建。众包把采集触点铺到社会场景,集中式训练场承担标准化与验证职能,两者数据口径能否对齐,决定了这些数据最终有多少能进入模型训练。



评论 0